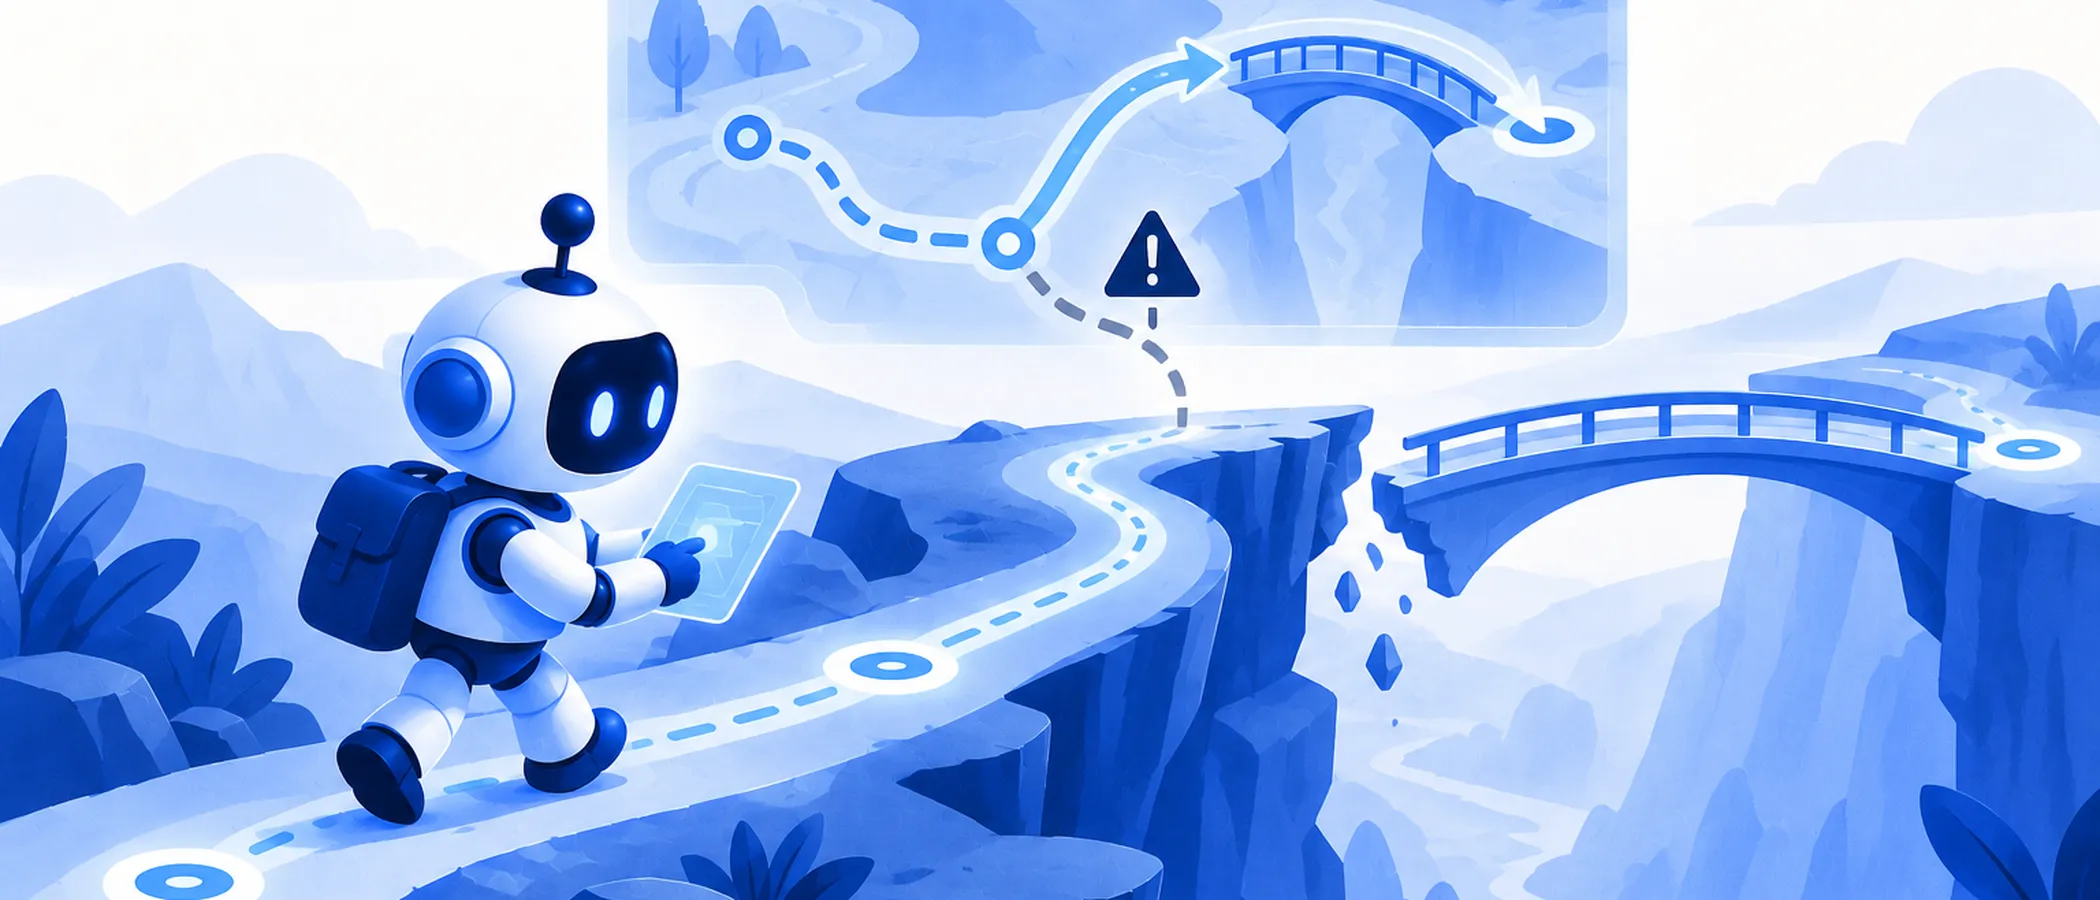
Forschende stellen mit PAWM (Pitfall Anticipation World Model) ein Hilfsmodell vor, das KI-Agenten auf Basis großer Sprachmodelle vor typischen Fehlern warnen soll. Es sagt nicht jeden Schritt der Umgebung voraus, sondern greift nur ein, wenn eine Falle droht. Das ist für alle interessant, die mit KI-Agenten arbeiten, denn der Ansatz zeigt, wie sich auch geschlossene Modelle ohne Zugriff auf ihre Gewichte gezielt unterstützen lassen.
Was ist passiert
Laut einer Veröffentlichung auf dem Preprint-Server arXiv beschreibt ein Forschungsteam ein Weltmodell für LLM-Agenten. Der Ausgangspunkt: Moderne, geschlossene Sprachmodelle sind gut darin, über lange Abläufe hinweg zu schlussfolgern und präzise Aktionen zu erzeugen. Ihnen fehlt aber verinnerlichtes Wissen darüber, wie sich eine bestimmte Umgebung verhält, etwa eine Simulation oder eine Webseite.
Ein Weltmodell soll diese Lücke füllen. Es sagt vorher, wie die Umgebung auf die geplante Aktion reagieren wird. Bisherige Weltmodelle für LLM-Agenten prognostizieren nach Angaben der Autoren meist die nächste Beobachtung in jedem Schritt. Das ist teuer und oft wenig aufschlussreich: Eine einzelne Beobachtung gibt nur begrenzt Hinweise für die Aufgabe, und nicht jeder Schritt braucht einen Blick nach vorn.
Daraus folgt die Leitfrage der Arbeit: Was soll ein Weltmodell vorhersagen, und wann soll es aufgerufen werden? Eine Vorstudie deutet darauf hin, dass die Hilfe am nützlichsten ist, wenn das Modell Fallstricke in einem begrenzten, mehrere Schritte umfassenden Zeitfenster vorhersieht.
Wie PAWM arbeitet
PAWM greift selektiv ein, nämlich nur dann, wenn ein möglicher Fallstrick auftaucht. In diesem Moment sagt es das drohende Scheitern voraus und lenkt den Agenten davon weg. Der Agent wird also nicht ständig begleitet, sondern bekommt gezielt eine Warnung, wenn es kritisch wird.
Das Training verläuft in zwei Stufen:
- Überwachtes Feintuning (SFT): Das Modell lernt zunächst anhand synthetischer Daten, die mit typischen Agentenfehlern markiert sind.
- GRPO-Ko-Training: Danach wird es gemeinsam mit einem Black-Box-LLM in der Zielumgebung weiter optimiert.
Die Ergebnisse
| Testumgebung | Verbesserung von Claude Sonnet 4.5 |
|---|---|
| ScienceWorld | 24,3 % |
| WebArena-Lite | 7,7 % |
Nach Angaben der Autoren übertrifft PAWM damit eine Reihe von Vergleichsverfahren. Die Zahlen stammen aus der Zusammenfassung der Studie. Ob es sich um relative oder absolute Zuwächse handelt, geht daraus nicht hervor und sollte im Volltext geprüft werden.
Hintergrund
Ein LLM-Agent ist ein Sprachmodell, das nicht nur Text beantwortet, sondern in einer Umgebung handelt. Es führt Schritt für Schritt Aktionen aus, beobachtet das Ergebnis und plant weiter. ScienceWorld und WebArena-Lite sind Testumgebungen dieser Art: Die eine ist auf naturwissenschaftliche Aufgaben ausgelegt, die andere auf Aufgaben im Web.
Warum geschlossene Modelle ein besonderes Problem sind
Bei einem Black-Box-Modell kann man weder die internen Parameter ändern noch es direkt nachtrainieren. Beeinflussen lässt sich nur, was hineingeht, etwa der Prompt oder zusätzliche Hinweise. Statt das große Modell anzupassen, trainiert man daher ein Hilfsmodell daneben, das dem Agenten im richtigen Moment nützliche Informationen zuspielt.
Weltmodelle in Kurzform
Der Begriff stammt aus der Forschung zu Planung und Reinforcement Learning. Ein Weltmodell schätzt ab, was in der Umgebung geschieht, wenn eine Aktion ausgeführt wird. Wer Folgen vorab einschätzen kann, muss nicht jede Option real ausprobieren. Das hilft besonders dort, wo ein Fehlversuch Zeit kostet oder sich nicht rückgängig machen lässt. Die PAWM-Autoren verlagern den Schwerpunkt von der lückenlosen Vorhersage hin zur gezielten Warnung vor Misserfolgen.
Eine verwandte Arbeit
Zeitgleich erschien auf arXiv eine weitere Arbeit mit einer verwandten Idee. Sie beschreibt ein Rahmenwerk, das zur Laufzeit arbeitet und von dem Regelungsverfahren Model Predictive Path Integral (MPPI) inspiriert ist. Der Agent schlägt mehrere Aktionen vor, ein Weltmodell spielt deren Ergebnisse durch, und die Alternativen werden verglichen, ohne sie in der echten Umgebung auszuführen. Die vorhergesagten Ergebnisse werden nach Aufgabenfortschritt und Risiko bewertet. Ein Erfahrungsspeicher mit zwei Zweigen soll Selbstverbesserung ermöglichen. Getestet wurde auf ALFWorld und ScienceWorld.
Beide Arbeiten gehen davon aus, dass Agenten von einem Blick in die Zukunft profitieren. Sie organisieren diesen Blick aber unterschiedlich: einmal als gezielte Warnung, einmal als Vergleich mehrerer Kandidaten mit Lernen aus Erfahrung.
Was das bedeutet
Die Studie ist ein Preprint, die Ergebnisse sind Angaben der Autoren. Einige vorsichtige Schlüsse lassen sich dennoch ziehen.
Für Entwicklerinnen und Entwickler
Nicht jede Vorhersage ist gleich wertvoll. Es kann sich lohnen, Hilfsmodelle nur dann einzuschalten, wenn ein Fehler wahrscheinlich ist. Das spart Rechenaufwand und vermeidet Hinweise, die den Agenten eher ablenken. Zudem zeigt die Arbeit, dass sich ein trainierbares Modul neben ein unveränderbares Modell stellen lässt.
Ob die Methode in anderen Umgebungen ähnlich wirkt, sagt die Zusammenfassung nicht. PAWM wird in der jeweiligen Zielumgebung weitertrainiert. Für eigene Projekte stellt sich daher die Frage, wie groß dieser Anpassungsaufwand ausfällt.
Für kleine Unternehmen
Wer Agenten für Routineaufgaben im Web testet, sollte die Zahlen nüchtern lesen. Der Zuwachs fällt sehr unterschiedlich aus: deutlich bei ScienceWorld, spürbar kleiner bei WebArena-Lite. Der Nutzen kann also stark von der Aufgabe abhängen. Vor einem Einsatz kann es sinnvoll sein, die typischen Fehlerquellen des eigenen Agenten zu sammeln. Aus solchen wiederkehrenden Fallstricken lernen Ansätze wie PAWM.
Für alle, die KI-Agenten nutzen
Dass ein Sprachmodell stark im Schlussfolgern ist, heißt nicht, dass es eine konkrete Umgebung zuverlässig durchschaut. Agenten scheitern oft an Details, die sich erst im Verlauf zeigen. Forschung wie diese versucht, solche Aussetzer abzufedern. Bis das in Alltagsprodukten ankommt, ist es ratsam, wichtige Aktionen eines Agenten selbst zu kontrollieren.
Häufige Fragen
Was ist PAWM?
PAWM steht für Pitfall Anticipation World Model. Es greift nur ein, wenn ein möglicher Fallstrick auftaucht, und sagt den bevorstehenden Fehler voraus, um den Agenten davon wegzulenken.
Worin unterscheidet sich PAWM von früheren Weltmodellen für LLM-Agenten?
Frühere Ansätze sagen meist bei jedem Schritt die nächste Beobachtung voraus. Das ist aufwendig und oft wenig aufschlussreich. PAWM konzentriert sich auf Fallstricke in einem begrenzten Zeitraum mehrerer Schritte.
Wie wird PAWM trainiert?
In zwei Stufen: zuerst überwachtes Feintuning (SFT) mit synthetischen Daten, die mit Agentenfehlern markiert sind, danach GRPO-Ko-Training mit einem Black-Box-LLM in der Zielumgebung.
Welche Verbesserungen wurden gemessen?
Bei Claude Sonnet 4.5 stieg die Leistung um 24,3 % auf ScienceWorld und um 7,7 % auf WebArena-Lite. PAWM übertraf dabei mehrere Vergleichsverfahren.

